Misschien gebruik je al AI-coding agents om geautomatiseerde tests te schrijven. In mijn vorige blog liet ik zien hoe je met coding agents en een goede inrichting van agent skills op een betrouwbare manier end-to-endtests (E2E-tests) kunt ontwikkelen, volgens de conventies en werkwijze van je eigen project. Maar wat als we deze agents niet alleen gebruiken om tests te schrijven, maar ook om onze applicaties daadwerkelijk te testen? Dat biedt mogelijkheden om nieuwe functionaliteiten te verkennen, uitzonderingssituaties (edge cases) te onderzoeken en al tijdens de ontwikkeling van een functionaliteit feedback te krijgen.
In dit artikel duiken we in agentic testing en leg ik uit waarom het een plek verdient binnen je teststrategie. Ik deel mijn ervaringen tot nu toe en laat zien waar deze autonome kwaliteitscontroles volgens mij waarde kunnen toevoegen. Hopelijk inspireert dit artikel je om er zelf mee te experimenteren! 😃
Het is tijd om naast gescripte testautomatisering ook autonome kwaliteitscontroles in je project op te nemen.
Wat is agentic testing?
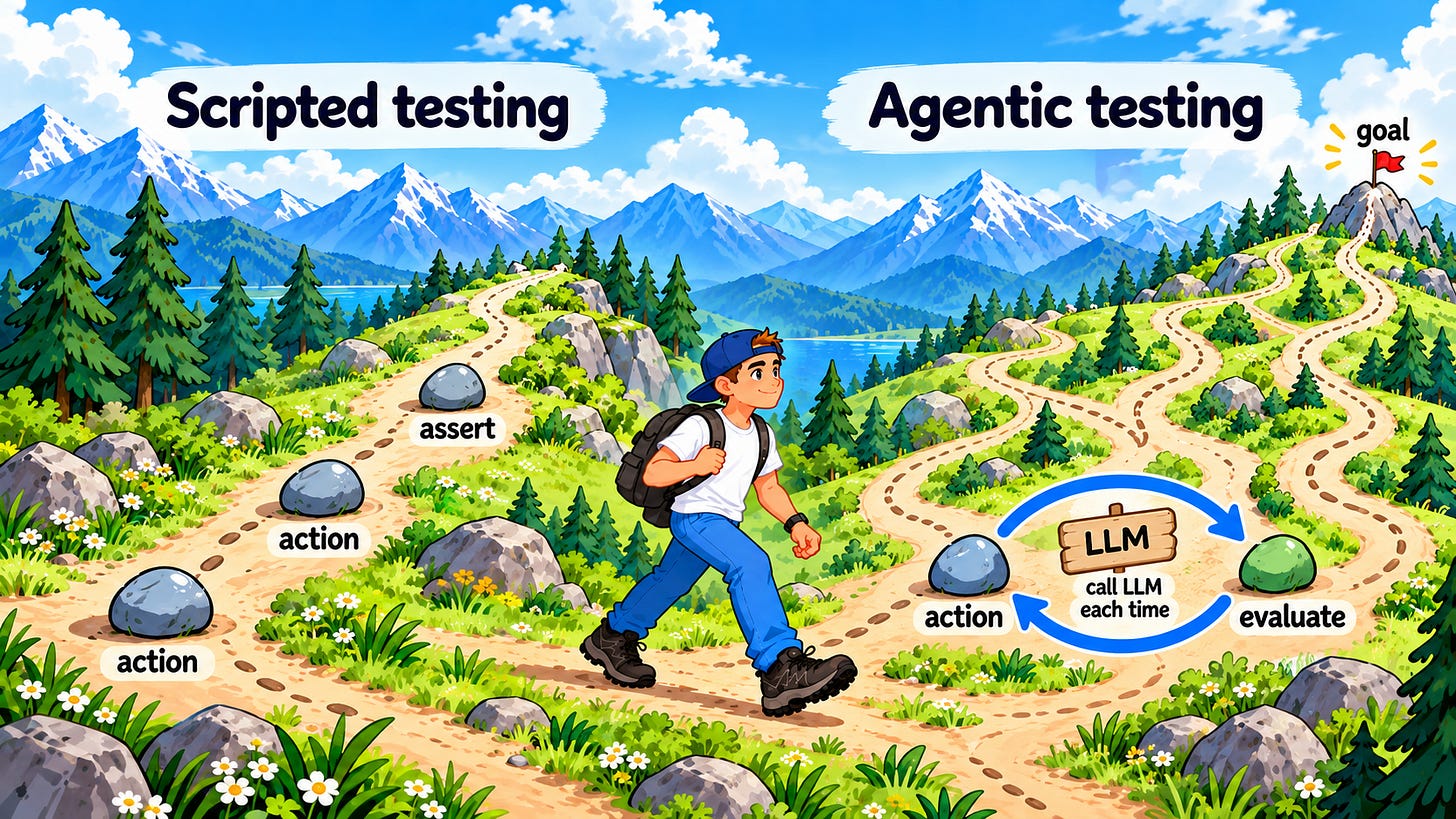
Gescripte testautomatisering is heel geschikt om een vooraf bepaald pad te volgen.
Action > Action > Assert
Bij agentic testing hebben AI-agents zo’n vooraf vastgesteld pad niet nodig. Ze kunnen zelf onderzoeken wat er in een applicatie gebeurt en op basis daarvan bepalen wat de volgende stap moet zijn. Dit doen ze in een herhalende cyclus: ze voeren een actie uit, evalueren de situatie en bepalen vervolgens wat nodig is om hun doel te bereiken.
Action > Make LLM call, evaluate current state towards goal > Next Action
Dat maakt agentic testing bijzonder flexibel. Tegelijkertijd zal het nooit zo snel, reproduceerbaar en nauwkeurig zijn als vooraf gedefinieerde testscripts.
Waarom agentic testing de moeite waard is
Afgelopen jaar heb ik meer dan twintig workshops over agentic AI gegeven. Wat me daarbij opviel, is dat veel mensen er graag mee aan de slag willen, maar niet goed weten waar ze moeten beginnen.
Sommige teams gebruiken inmiddels AI-coding agents om geautomatiseerde tests te schrijven, maar slechts weinig teams zetten agentic AI daadwerkelijk in om te testen.
Volgens mij komt dat deels doordat niet meteen duidelijk is waar agentic testing waarde toevoegt.
Autonome agents zijn vooral interessant bij het testen van nieuwe functionaliteiten die nog volop in ontwikkeling zijn. Ze kunnen een functionaliteit verkennen, reageren op wat ze tegenkomen, de benodigde testdata aanmaken en scenario’s onderzoeken die vooraf niet expliciet zijn vastgelegd.

Hoewel een agent langzamer werkt dan een gescripte Playwright-test, kan deze nog steeds veel sneller feedback opleveren dan wanneer je moet wachten op een handmatige controle.
Wanneer zet je agentic testing in?
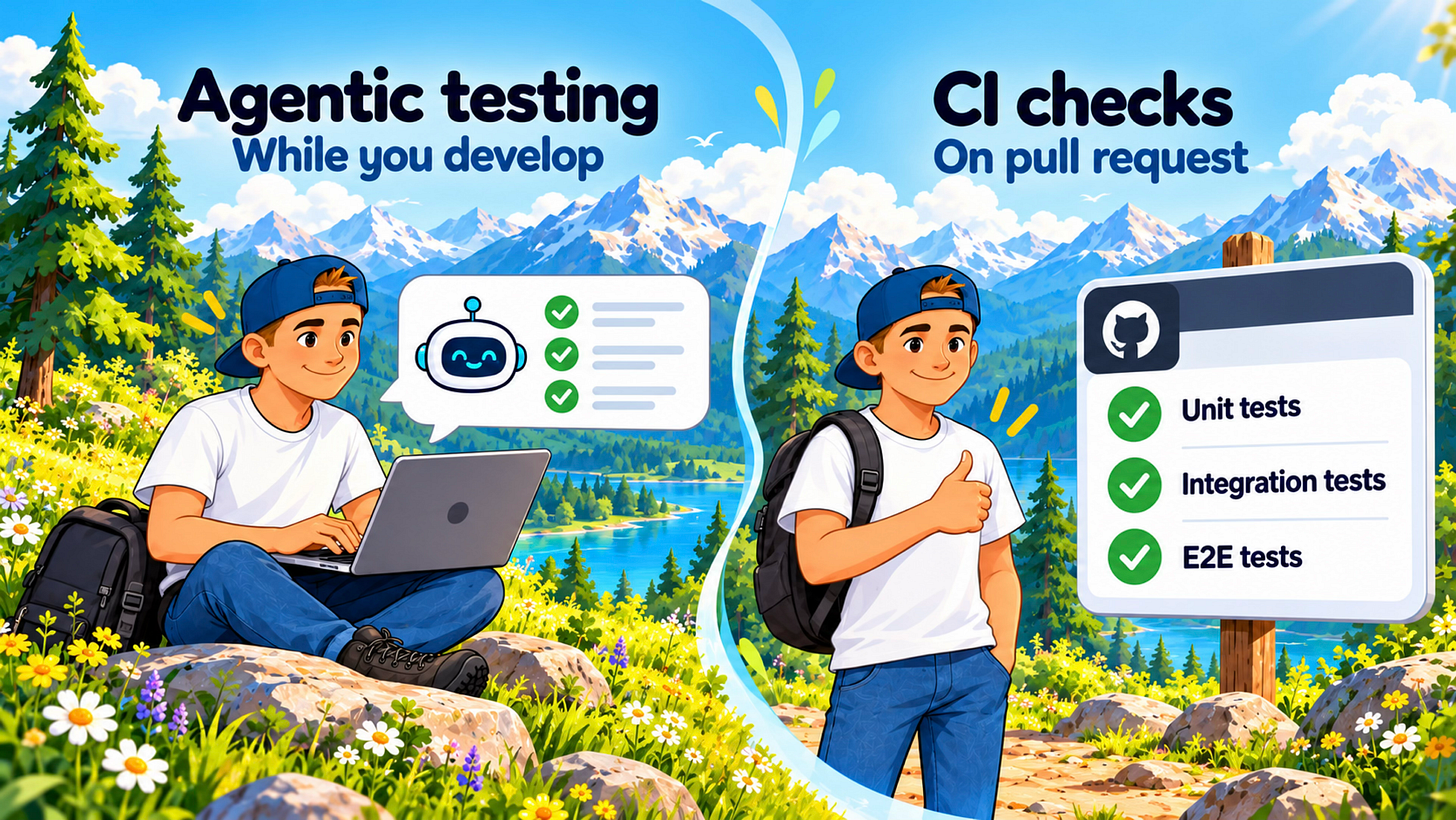
Ik denk dat agentic testing vooral tijdens de ontwikkeling zelf veel waarde kan toevoegen.
Bij shift-left testing draait alles om zo vroeg mogelijk feedback krijgen. Met AI-agents wordt het nu een stuk eenvoudiger om al tijdens de ontwikkeling verkennende end-to-endtests uit te voeren.
In plaats van te wachten totdat een functionaliteit volledig is afgerond, kun je een agent gedurende het ontwikkelproces laten controleren of de implementatie naar behoren werkt.
Ik denk dat dit enorm kan bijdragen aan de algehele kwaliteit. Het wordt steeds eenvoudiger om met minimale inspanning veel controles uit te voeren, zelfs voordat er een pull request is aangemaakt!
Gescripte testautomatisering vormt hierop een waardevolle aanvulling. Die zorgt namelijk voor snelle, betrouwbare en herhaalbare regressietests binnen de CI-pipeline.
Wat ik daarnaast interessant vind, is dat testen steeds meer een interactief proces wordt.
Tijdens het ontwikkelen van een user story kan ik een agent bijvoorbeeld vragen om de functionaliteit te testen die tot dan toe is gebouwd. Meestal begint de agent met de belangrijkste happy flows en rapporteert vervolgens de bevindingen. Na het bekijken van de resultaten kan ik de agent vragen om aanvullende edge cases te onderzoeken, zich te richten op een specifiek scenario of iets nader te bekijken dat verdacht lijkt.
Die voortdurende wisselwerking maakt verkennend testen een stuk minder tijdrovend en kostbaar.
Voorheen betekende beperkte tijd vaak dat je keuzes moest maken: welke scenario’s test je wel en welke sla je over? Met autonome agents wordt het haalbaar om veel meer scenario’s te onderzoeken.
En dit beperkt zich niet tot functioneel testen. Je kunt een agent bijvoorbeeld ook vragen om toetsenbordnavigatie, toegankelijkheid, validatiestatussen, foutafhandeling of andere kwaliteitsaspecten te controleren die anders misschien minder aandacht krijgen.
Ik ben ervan overtuigd dat een goede, moderne teststrategie zowel agentic testing als gescripte testautomatisering moet omvatten.
Dat betekent overigens niet dat ontwikkelaars verantwoordelijk moeten worden voor alle testactiviteiten. Ook binnen een meer traditionele werkwijze kunnen testers deze aanpak gebruiken zodra een functionaliteit beschikbaar is in een testomgeving. Laat agents het uitvoerende en verkennende testwerk doen, terwijl de tester zich richt op het aansturen van de tests en het beoordelen van het verzamelde bewijsmateriaal.
Kun je jouw AI-agent vertrouwen?
Maar AI-agents maken fouten. Ze hallucineren, vullen ontbrekende informatie zelf in en volgen instructies niet altijd goed op.
Hoe kunnen we een AI-testagent dan ooit vertrouwen?
Na het uitvoeren van veel agentic tests heb ik geleerd dat het bieden van de juiste context een groot verschil maakt. Duidelijke requirements en randvoorwaarden helpen agents beter te begrijpen wat ze moeten testen en verminderen het aantal aannames dat ze moeten doen.
Maar dat betekent niet dat ik de resultaten automatisch vertrouw.
Vertrouwen begint bij bewijs.
Ik wil kunnen zien welke scenario’s de agent heeft uitgevoerd, welke stappen zijn doorlopen, wat de agent heeft waargenomen en waarom deze concludeert dat de functionaliteit correct werkt.
Op basis van dat bewijsmateriaal kan ik zelf bepalen hoeveel vertrouwen ik in de resultaten heb.
Bovendien wordt het voor de agent hierdoor een stuk lastiger om de makkelijke weg te kiezen. In plaats van simpelweg te melden dat een test geslaagd is, moet de agent laten zien wat er daadwerkelijk is uitgevoerd.
Mijn rol verschuift daarmee van het zelf uitvoeren van iedere test naar het beoordelen of de controles voldoende zijn en of het verzamelde bewijs de conclusies ondersteunt.
Zijn de controles niet voldoende? Dan vraag ik de agent om aanvullende edge cases te onderzoeken, een specifiek scenario te testen of geef ik extra context om de test opnieuw uit te voeren.
Mijn agentic testing skill
Hoe ziet dit eruit in een echt project?
Ik heb een test-user-story skill ontwikkeld die een user story of beschrijving van een functionaliteit als input gebruikt en vervolgens het verkennende testwerk voor mij uitvoert. Deze skill kan ook informatie hergebruiken uit onze bestaande gescripte E2E-testomgeving, zoals testdata, gebruikers en URL’s van testomgevingen.
Het proces ziet er ongeveer zo uit:
- De agent ontvangt een user story of beschrijving van de functionaliteit.
- Op basis daarvan stelt de agent relevante testscenario’s op.
- De agent vraagt welke scenario’s moeten worden uitgevoerd, in welke omgeving en welk type bewijsmateriaal moet worden vastgelegd.
- Vervolgens voert de agent de geselecteerde scenario’s uit met behulp van playwright-cli.
- Tot slot genereert de agent een consistent testrapport met de resultaten en het bijbehorende bewijsmateriaal.
Het rapporttemplate bestaat uit HTML en een klein script dat de resultaten van de testuitvoering invult. Wanneer er een rapport moet worden gemaakt, roept de agent dit script aan met de verzamelde resultaten.
In plaats van iedere keer een rapport in een andere vorm te ontvangen, krijg ik zo een voorspelbaar en consistent overzicht dat eenvoudig te bekijken en te beoordelen is. Nog belangrijker: het rapport vormt een concreet bewijs van wat de agent daadwerkelijk heeft getest, in plaats van alleen een eindconclusie.
Bekijk de volledige skill op mijn GitHub.
Conclusie
Voor mij zijn dit de belangrijkste lessen uit mijn ervaringen met agentic testing:
- Agentic testing vervangt gescripte testautomatisering niet, maar vormt hierop een waardevolle aanvulling. Gescripte tests blijven ideaal voor snelle en betrouwbare regressiecontroles binnen CI.
- Agentic testing voegt waarde toe door nieuwe functionaliteiten te verkennen, edge cases te testen en veel eerder in het ontwikkelproces feedback te geven. Een moderne teststrategie zou daarom beide vormen van testautomatisering moeten combineren.
- De sleutel is om een AI-agent niet blindelings te vertrouwen, maar het bewijsmateriaal kritisch te beoordelen.
- Als (quality) engineers moeten we agentic testing en de mogelijkheden die het biedt omarmen. Softwareontwikkeling verandert razendsnel en daarmee ontstaan ook nieuwe, interessante mogelijkheden.
Laten we deze ontwikkelingen omarmen en samen vormgeven aan de toekomst van softwaretesten!